OpenAI 洞悉了一种隐藏于众目睽睽之下的特殊而稀有的东西。正如彼得·德鲁克半个世纪前所言,企业的目的就是创造客户。
OpenAI 不会因为他们拥有最好的模型、最先进的芯片、最优越的成本效益曲线,乃至最好的产品而获胜,尽管我们确实认为他们具备这些。我们认为 OpenAI 最终会赢,是因为他们极擅长创造新型客户,并拥有最持久的分发策略。
在我们写下这些文字的 2026 年 9 月,智能即服务的产品排名已不再是至关重要的问题。智能无处不在。任何人都几乎可以做到任何事;但大多数人,还没有去这么做。能否唤醒新的行为习惯,以及能否在分发层面胜出,才是关键所在。

支持 OpenAI 的论点可以归结为以下论述。要在 AI 前沿规模上打造一项持久的业务,有四个杠杆可供利用:
- 创造新型行为
- 触达海量用户
- 以能捕获价值的方式定价
- 拥有高转换成本
第四点基本上已经出局了。AI 前沿领域是一场红皇后竞赛,至少在模型层面如此。模型之间的切换极其容易,甚至能细化到逐个任务切换,而且所有模型都在持续进化。
第三点则是所有人的期望。但同样的,外部世界竞争极其激烈,OpenAI(以及其他公司)决心在成本计算的前沿保持领先,并通过规模经济、垂直整合等策略来降低 token 成本。无论如何,在性价比上最终领先的,就是那个在规模上领先的玩家。
这意味着归根结底,胜败取决于第一和第二点。我们认为 OpenAI 在第一点上明显是最强的:
- 在 AI 领域,他们拥有寻找那些简单、事后看来显而易见、却能解锁全新消费行为突破的骄人记录
同时,他们在第二点上也是最强的:
- 当下每个 AI 实验室都在试图加速超越自家产品的分发能力。而在这方面,有两条路可走:作为平台,或通过合作伙伴关系。作为真正的平台来运作,在长期来看更为可取:收入来得稍慢一些,但一旦成功,其模式会更具持久性和价值。
OpenAI 之所以能在第一和第二点上占据优势,有一个根本原因,那就是他们拥有最广泛、最全面的通用智能,这不仅体现在他们的模型中,也存在于他们的公司和客户基础中。他们接触着最广泛的用户群体(涵盖消费者、产消者和企业),拥有最深厚的能自我迭代的技术栈(深入至其自研芯片),这就是为什么他们能持续发现行之有效的新模式和新原语。他们正以长远的眼光构建制胜的 AI 平台,而这正在奏效。
OpenAI 极其擅长发现“下一件事”
OpenAI 最初的定位并非一家消费者公司。他们算是偶然地,随着 ChatGPT 的发布,跌跌撞撞进入了这个领域。这是一个幸运的意外,因为那一刻是技术史上的转折点之一。假如他们没有这么做,世界会大不相同。AI 可能仍被守护在实验室和密切客户的手中,其进步速度远不及现在,我们将身处一个"默认封闭"的时间线,而非如今这个无比丰富的世界。
Sam Altman 最近分享了一个故事,关于 ChatGPT 发布后的几周,那时 OpenAI 的大多数人都抱着这样的态度:“嗯,这挺有趣,但我们或许该继续前进,去打造一些真正的产品了。一个聊天机器人,总不能就是这个了吧?” 正是 Peter Thiel 特意劝告 Sam,不,就是这个。你已经创造了一种新客户。没有比这更重要的事了。
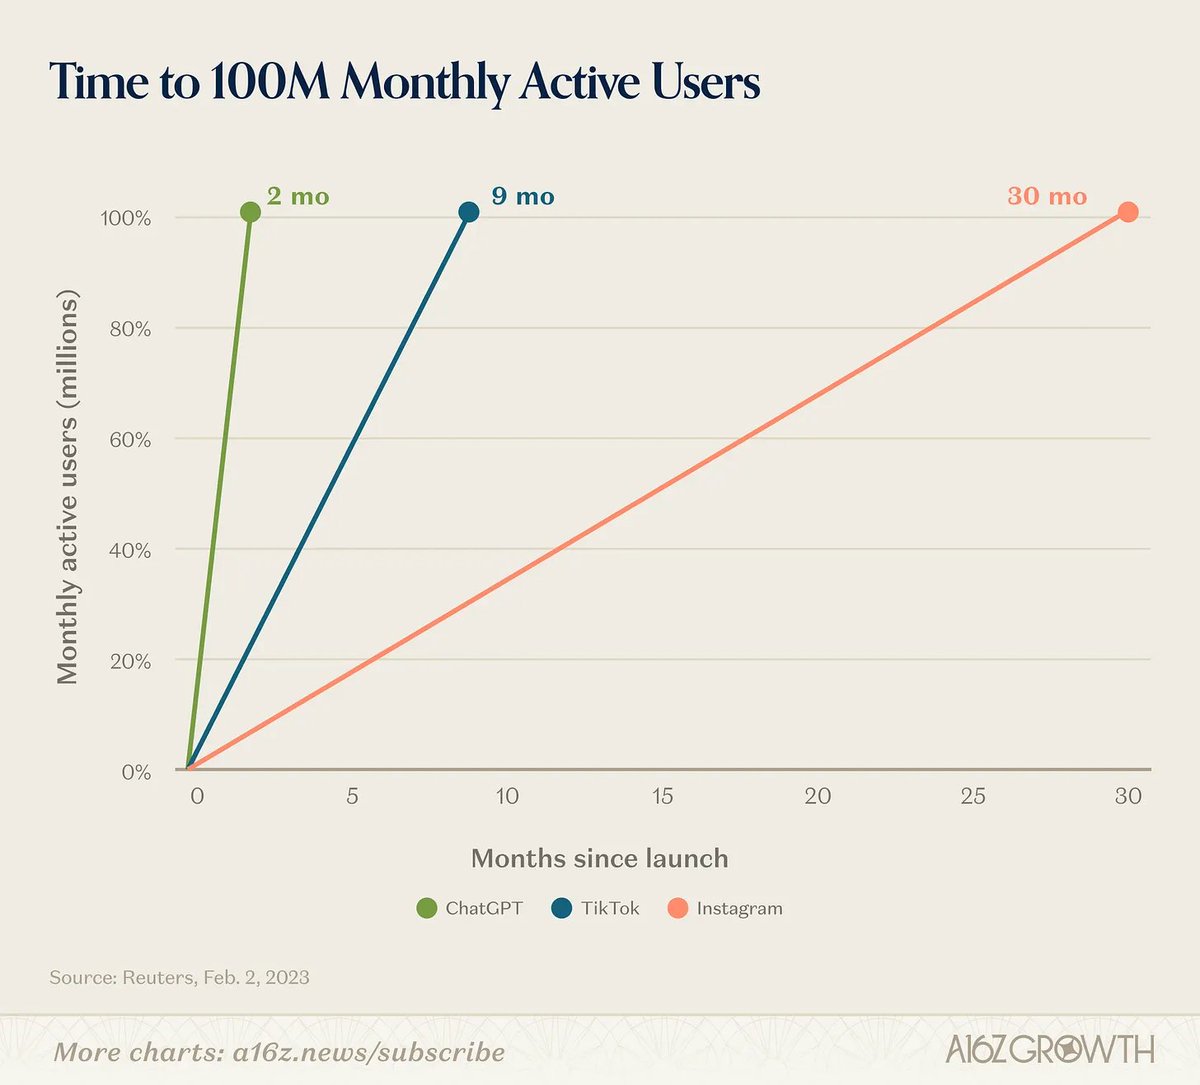
这也不仅仅是 ChatGPT:OpenAI 总体上擅长发现真正重要的突破性模式与原语,并唤醒新的用户行为,这值得称赞。Ben Hylak 在几天前的一篇文章中清晰地阐述了这一点:“OpenAI 是寻找‘下一件事’领域(几乎)不败的王者。这件事总是比你想象的要简单得多,事后看来显而易见。” GPT 聊天界面、推理、工具调用以及 Computer Use,这些都是重大的突破,它们简化并聚焦了技术的发展方向,使其变得可用。一个主要的例外是编程领域,OpenAI 并非最初的突破领导者,但他们也很好地追赶了上来。
他们为什么如此擅长这一点?也许在早期,他们只是拥有那种特殊的秘方;没有人能确切说清楚,是什么创始能量和魔力催生了这样的存在。但随着时间的推移,这显然已成为他们刻意培养的一种技能。这里有三个关键输入因素:
- 他们的思考和行动方式,就像一家想成为平台的公司。“平台”是一个内涵丰富的术语,我们稍后会详细探讨,但这是一家真正相信其用户是聪明的,并且能够在精心设计的约束条件下做出自己选择的公司。
- 他们正加倍投入技术深度,这意味着他们试图拥有或控制其技术栈的每一个深层次,并持续精炼其用户所需的平台原语,作为构建的基石。
- 也许最重要的是,他们拥有巨大的消费者广度。在横跨用户个人与工作生活的各种消费者类型和使用场景的纯粹多样性上,他们依然保持领先。
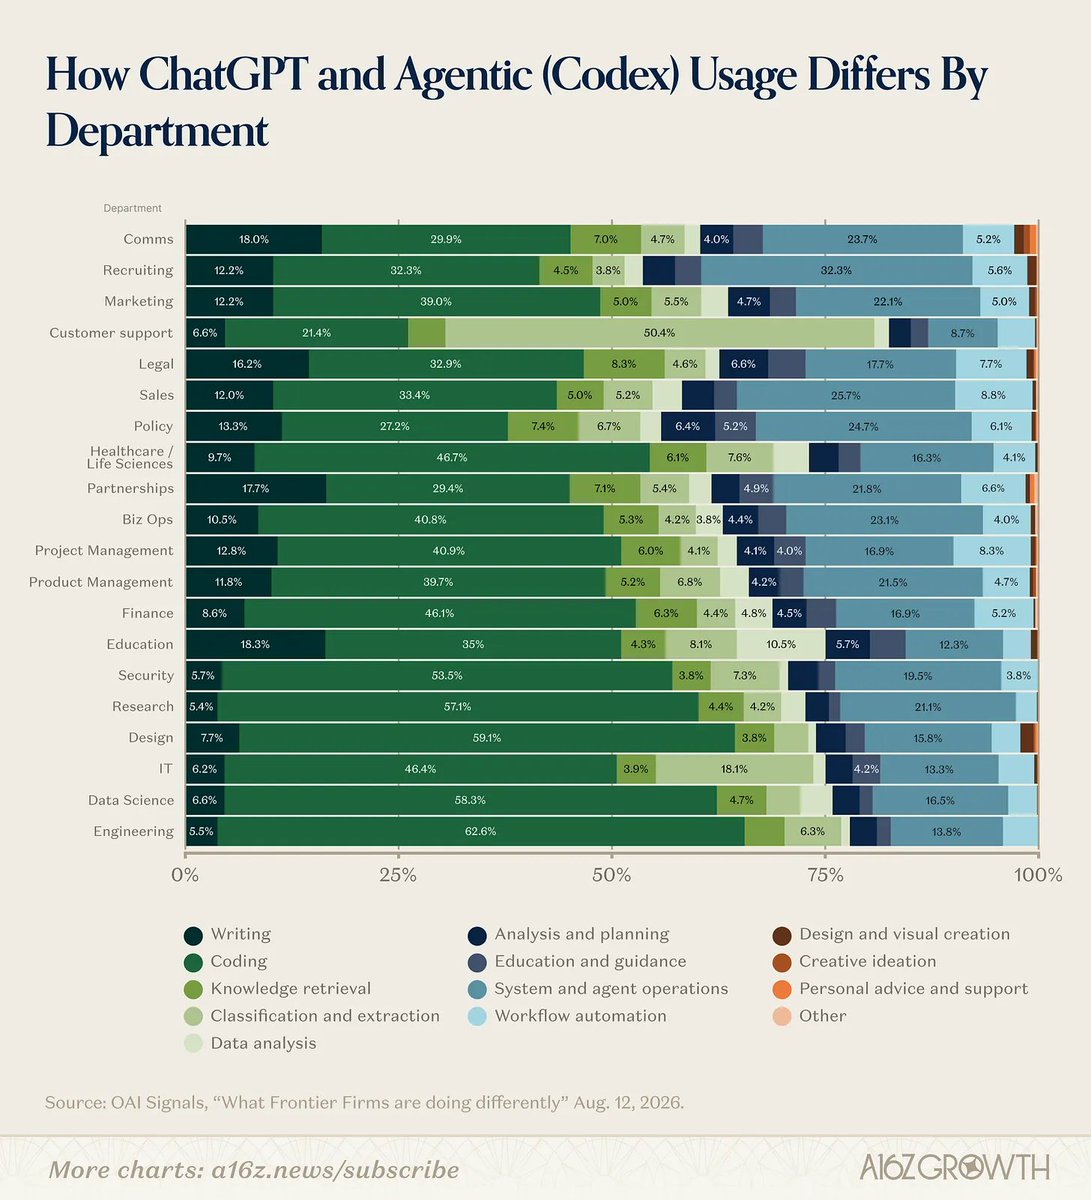
人们使用它们的广度是这里最被低估的因素。正如赫拉克简洁地指出的那样:“例如,‘计算机使用’是一个非常通用且不具体的事情。要在这方面做得更好,你需要以一种通用的方式提升你的智能——跨越众多领域,跨越众多工作流程。”人们总是低估从特定解决方案走向通用解决方案的难度。但你通常只有在追求通用解决方案的过程中,才会(事后看来)发现那些简单明了、却又通用且不具体(作为需要解决的问题)的东西。
为什么多数公司不追求“通用解决方案”?因为这实际上成本相当高,并且与运营一个专注型产品组织的大多数最佳实践背道而驰。你需要从海量的客户、行为和动作中收集输入,让他们几乎做任何他们想做的事情,才能在一个领域取得通用进展,而不是在一个产品上取得特定进展。
这意味着,将“通用知识”构建到你的产品中的能力,实际上取决于你的分发策略。这一点并不显而易见,但非常重要,而 OpenAI 深知其理。
你如何大规模地为每个人提供“我确切想要的东西”(这可能是非常定制化、特定且挑剔的)?
基本上有三种方式。你可以通过独立产品来提供,可以通过合作伙伴关系来提供,或者可以将其作为平台来提供。
- 独立产品有一个有利的约束,即你的产品必须从本质上让用户“做任何他们想做的事”(比如向 ChatGPT 提出任何问题),因此你是在真正地创造客户体验,从将产品送到他们手中,到观察他们日常使用。
- 通过合作伙伴关系进行分发的好处在于,合作伙伴能让你围绕大量用例迅速获得广泛触达。但最终,是合作伙伴拥有并引导着客户那种“我想做什么都行”的本能。因此,长期来看,不仅他们很可能会攫取诱人的经济利益,他们还控制着用户最终能做什么,以及哪些东西会被学习。此外,你的客户甚至可能不知道背后是你在提供支持,因此你无法从他们那里获得任何信任或好感。
- 以平台形式进行分发,意味着人们在你的基础上构建任何他们想要的东西。这个过程是缓慢的,因为你需要从零开始,制造出所有支持“我想做什么都行”的新产品。但一旦建立起来,它就非常强大,因为即使收入来得更慢或抽成比例较低,你也已经建立了一个非常强大的关于世界的学习循环——用户在使用你的基元(primitives)和模式的过程中,会告诉你关于这个世界的信息,以及人们想从你这里得到什么。这种学习不是在“用客户数据训练”那个意义上,而是在“基元变成了对这片领域更精准的描绘”这个意义上。
在足够长的时间跨度里,产品会来来去去,合作关系的动态会改变,它们的经济效益也可能相对预期令人失望。但 OpenAI 一次又一次地回归,带着构建持久平台的驱动力。而他们正在做的事情,是有效的。
真正的平台很稀有,但值得去做
平台很难构建,也很难说清其道理。它们甚至很难定义!
通常,我们对平台有一个宽泛而模糊的概念,即“平台让人们为自己的特定需求构建东西”。
在软件领域,有几种方式可以做到这一点。十九年前,马克写过一篇名为《你在互联网上会遇到三种平台》的文章,至今仍然很有用。马克的定义是:“‘平台’是一个可以被外部开发者——也就是用户——编程并因此定制的系统,通过这种方式,它能适应无数连平台原始开发者都未曾设想过(更不用说有时间去兼顾)的需求和细分领域。”
这“三种类型”对应于三种不同的计算机组织方式,以便用户获得他们想要的定制化结果。它们(按从一型到三型的上升顺序)构建难度逐渐增加,但在解锁的行为和构建能力方面,却更加神奇。
- 第一型是我们今天所说的“无头式”——通过 API 为用户提供一些有用的功能访问(比如当年的 Flickr,甚至如今一些像 Stripe 这样极具价值的公司也归入此类)。
- 第二型使用的是你所说的“插件模式”:例如旧的 Facebook 平台,或者现在大多数 Shopify 或 HubSpot 的应用。你有一个核心服务,满足用户 80% 的需求,然后有自定义的应用程序运行在它们自己的服务器上,可能通过某种应用商店进行管理,这些应用为用户提供他们想要的定制化体验。
- 第三型是关键的一类:它是一个名副其实的运行时环境,人们可以在其中编程来创建任何他们想要的东西。这类平台构建起来真的非常非常困难,但一旦成功运作,便真正拥有魔力。iOS、AWS、以太坊,以及最近的 Cloudflare 都是这类的例子。
当今人工智能领域有趣的一点在于,从某种意义上说,所有的模型公司和推理服务提供商,都可以声称自己在进行“第三型平台”的工作。(模型就是一种运行时,通过自定义指令进行提示!)但仅凭模型本身并不能解锁新的行为,它们也没有那么强的防御性。正如我们在编程领域看到的,那里的工具框架(the harness)同样重要。在这里,真正起决定作用的是由约束和基元构成的上层建筑。我们会给出一个理论原因和一个实际原因来解释这点。
从理论上看,原因在于:如果你想发现那些事后看来显而易见的模式和原语(primitives),而它们将真正带来实质性影响,你就必须尽可能广泛地接触用户的使用行为、隐性知识和反复试错,这样才能从一个特化的产品(局部突破)进化成一个通用的产品(全局突破)。而做到这一点最纯粹的方式,就是让用户能够为实现自己的目标编写任意的指令——也就是“代码”。想要把安全性、访问控制、数据结构和约束都做对,是一项极其庞大的工程,“产品导向”的公司往往很难将其排到高优先级;只有真正下定决心的团队才能抵达那片应许之地。
从实践上看,就人工智能目前的状况而言,要让智能体(agents)真正有用,它们就必须能够写代码。这一点或许并不显而易见,但却是我们在过去一年里学到的东西。尽管AI模型在编写代码方面表现得极为出色,但在日常工作型知识任务中调用工具或执行指令时,它们却出人意料地笨拙——除非你换一种思路,说“写一个能完成这些任务的程序”,这样一来它们反而做得非常好。目前企业AI应用中的一个悬而未决的问题是:“人与组织如何安全地支撑这一切?”你大概率应该押注那些有平台思维的人来把这件事做对。
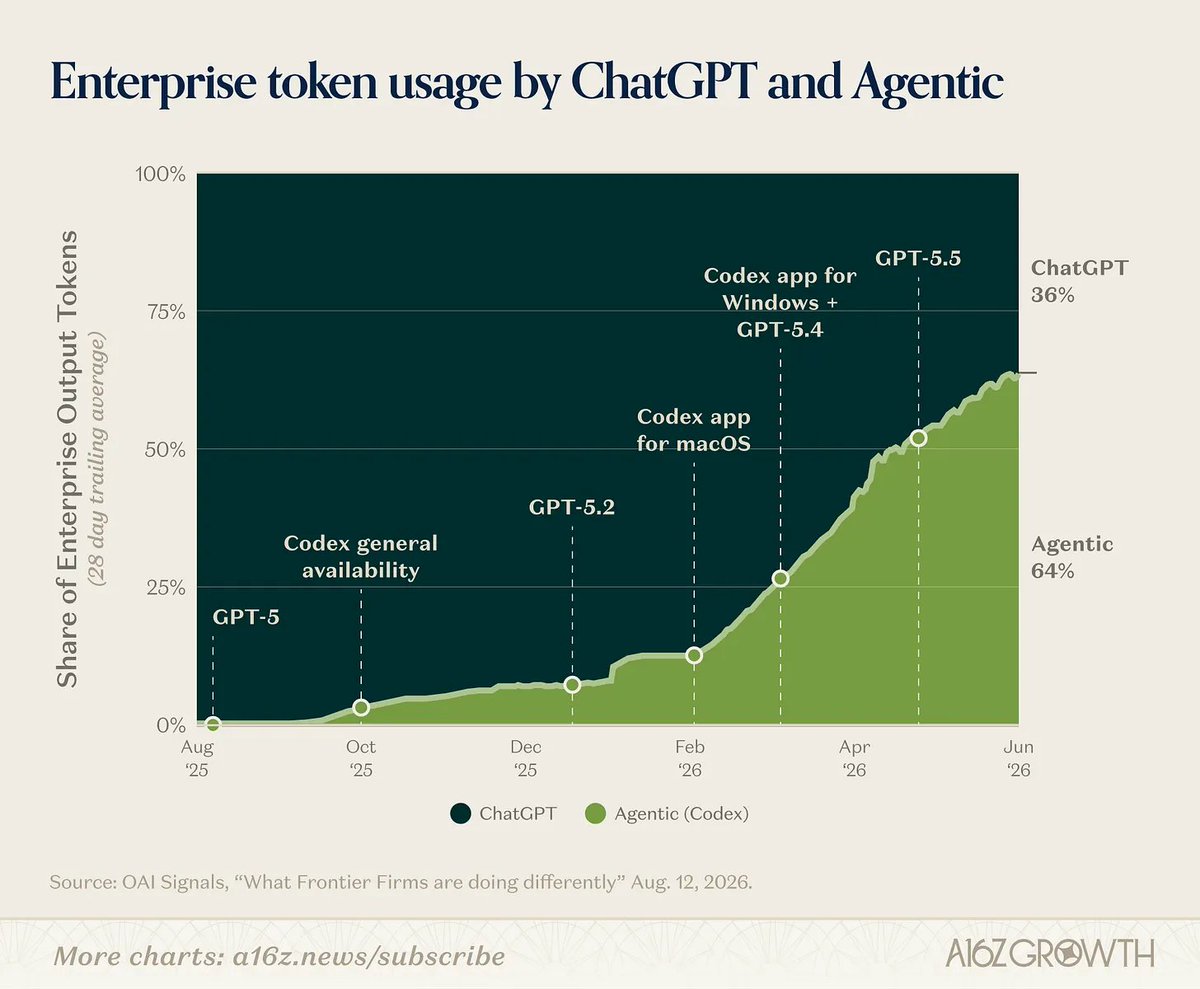
当前一个重大的开放问题是:在AI技术栈的各个层级上,究竟会出现怎样的网络效应、转换成本以及其他护城河。就目前而言,模型层仍然令人震惊地可以相互替代。大家普遍感觉,“多人模式”(例如项目协作、某个智能体被朋友的智能体所信任)确实包含了一些有利于商业模式防御性的成分,但它至今尚未真正冲击到我们围绕代币支出所看到的“用量攀升、成本下降”的整体混战。最核心的问题并不是“你的模型有没有粘性”,而是“你有没有创造出新的用户行为?”正如Steve Hou说得好:“真正重要的弹性,不是模型之间的替代弹性,而是对人工智能总需求的弹性。”
模式匹配从来都不是完美的,但如果过去四年AI的发展能说明什么的话,那就是:接下来,在普通人可以防御性地、以多人模式使用的AI领域,重大突破将诞生于一些顿悟时刻——在这些时刻,我们找到了智能模型、计算原语和行为模式之间的最佳分层方式,然后某个简单而显然的东西就会浮现出来。它可能来自那些以模型公司为平台进行开发的创业公司,也可能来自模型公司本身。无论哪种方式,OpenAI显然都想要为它提供动力,并将其交付给用户。
在丰裕的世界里,因果关系是倒过来的
旧习惯很难根除。按照常规的商业分析思路,你可能会审视一家AI前沿实验室的各种显而易见的因素来评估其竞争优势:谁的模型最好?谁的芯片最好?谁的性价比最高?谁的产品最好?
显然,这些因素仍然都很重要。但是,在一个智能触手可及、按需供应的丰裕世界里,如果我们认为拥有所有这些优势就意味着胜出,那我们很可能把因果关系搞反了。我们认为,在未来,OpenAI之所以会拥有最好的模型、芯片和产品,是因为他们拥有最好的分发能力,而不是反过来。到目前为止,他们做出了很好的决策:获取足够算力、高效地训练模型、开发Jalapeno作为一款优化的芯片,以及做好其他一系列能在AI竞争格局中带来实质性优势的实操性工作。但在未来,我们认为他们将持续胜出,因为他们在获取关于这个世界的、来自他们自己新唤醒的用户的信息并在此基础上自我进化这方面,将始终站在最前沿。

新的产品和模型发布可能会在几周内吸引所有人的注意力,但从长远来看,我们并不真的认为OpenAI会在至关重要的维度上放弃他们的领导地位:
- 他们保持了最具统治力的消费品牌以及极其广泛的用户覆盖;
- 他们唤醒了全新的用户行为,这些行为事后看来理所当然,并且彻底改变了对“可能性”的定义;
- 他们在模型供应方面始终推进着“最好模型、最优价格”的前沿;
- 他们的“飞轮”从来不停,所有环节一同进化。
Sam将OpenAI未来的产品形态描述为只提供两种选择:要么你想做什么,就能直接做出来;要么你就只是和ChatGPT对话。这就是真正的丰裕在一种产品中的样子。你可以精确描述你想要什么、什么对你有帮助,然后得到它;或者你也可以退一步说:“或者我就对着这个文本框聊聊,看看自己能往哪儿走。”
这份丰裕是普遍可及的,就在今天。目前只有相当小一群人,在生活中几乎一切方面都在泛滥地使用AI;还有一个人数更多、更广泛的群体,在定期使用ChatGPT。但他们作为用户,尚未被真正唤醒。而谁会去唤醒他们呢?
我们认为,OpenAI知道该如何做到。